
 /


Clockwork推出YOCO保证,终结AI训练重启难题
在大规模GPU集群中,硬件故障几乎是家常便饭。传统的应对方式是回滚到上一个检查点,重新计算此后的所有内容,这不仅耗时,更意味着真金白银的浪费。Clockwork希望彻底改变这一现状,并愿意为此提供合同级别的保障。
Clockwork实现这一目标的核心产品是TorchPass——一款容错工具,已于今年3月正式推出。当某块GPU或整个节点发生故障时,TorchPass能够将训练任务的内存状态(包括模型权重、梯度和优化器状态)迁移到健康的备用GPU上,或者迁移到正在运行低优先级任务的GPU上,让训练任务持续运行,通常只需几分钟即可恢复。
本周三,Clockwork正式发布了YOCO保证,全称"You Only Compute Once"(只算一次)。该公司承诺,在受支持的训练任务中,90%的故障将在不丢失任何进度、不回滚检查点、不重新计算的情况下得到解决。如果Clockwork在某个合同年内未能达到这一标准,客户将获得下次续约或扩容费用25%的抵扣额度。
Clockwork首席执行官Suresh Vasudevan表示:"AI团队需要的是模型训练完成,而不只是节点保持在线。整个行业一直把节点在线率当作可靠性指标,而YOCO让我们真正对那件最重要的事负责——你的模型,训完为止。"
Clockwork联合创始人兼首席商务官Dan Zheng向媒体介绍了当前行业普遍面临的困境:"如果你定期保存检查点,一旦发生故障,就必须回到上一个检查点,可能是一小时前,也可能是两小时前,然后重新计算所有内容。"这些重新计算的工作当然不是免费的,团队必须为重复的GPU计算时间付出额外成本。
TorchPass通过"在任务运行过程中直接迁移"来绕开检查点回滚问题。Zheng将其比作VMware的vMotion技术——无需停机即可在物理主机之间迁移运行中的虚拟机,而TorchPass做的是GPU版本的同类操作,他戏称之为"gMotion"。
迁移的目标节点可以是预先保留的热备节点,也可以是正在运行低优先级任务的节点。TorchPass会中止低优先级任务,将该节点纳入训练集群,重建GPU间的连接,使训练从下一个步骤继续,而非从上一个检查点重来。
TorchPass还不必等到故障发生才行动。当预警信号已经出现时,它可以提前主动迁移任务。Zheng举例说:"如果GPU温度超过某个阈值,说明它迟早会故障。为什么不在还能访问GPU内存的时候提前处理?"
TorchPass提供两种工作模式,主要区别在于需要迁移的状态数据量及对应的恢复速度。
第一种是模型感知模式,只需在训练代码中添加几行代码。TorchPass能精确识别需要迁移的数据,因此迁移数据量更小,可在数十秒内完成恢复。
第二种是模型透明模式,无需对训练代码做任何修改,TorchPass在系统层面进行快照。这种方式使用门槛更低,但代价是需要迁移更多数据,恢复时间约为几分钟。
对于节点突然崩溃的情况,由于无法对一个已经宕机的节点进行快照,Clockwork的解决方案是利用任务已有的健康数据并行副本来重建丢失工作节点的状态。
当然,TorchPass也有其局限性。Zheng坦承:"如果整个网络都宕机了,那谁都没有办法。就像完全断电一样,任何人都无能为力。"
大规模集群中的故障并非偶发事件。Clockwork援引Meta FAIR团队的研究数据指出:1024块GPU的集群平均故障间隔时间为7.9小时,而扩展到16384块GPU时,这一数字骤降至1.8小时。Clockwork表示,这导致GPU集群的实际运行效率仅为理论性能的30%至50%。问题的症结并不在于硬件本身,而在于整个可靠性模型严重低估了集群实际遭遇的故障频率。
Clockwork估算,在一个典型的2048块H200 GPU部署环境中,由故障引发的重启每年会浪费超过600万美元的算力成本。
Zheng明确了目标客户群体:"这个解决方案不是为Anthropic和OpenAI准备的,因为他们有足够强大的工程团队。也不是为谷歌准备的。它真正面向的是其他所有人。"他指的是那些希望获得"顶级AI实验室级别弹性能力"、但又不想自行研发的AI原生初创公司、企业用户,以及量化投资和生物科技公司。随着越来越多的工作从预训练转向后训练和强化学习,涉及大规模训练任务的团队比一年前大幅增加,这一市场正在快速扩张。Clockwork表示,其现有客户已包括Nebius、Nscale、WhiteFiber等新兴云服务商,以及Uber、富国银行等大型企业。
不过,市场认知仍有待提升。Zheng说:"我们接触的很多人太习惯于检查点重启模式了,他们甚至不知道还有别的选择。"
目前的主流替代方案之一是行业现状本身——频繁保存检查点,出了问题就接受重新计算的代价。另一个选项是Meta于2024年底发布的开源框架TorchFT,其应对GPU故障的方式是直接丢弃整个副本组,在替换节点就位前以缺失状态继续运行。Clockwork指出,TorchFT在每个训练步骤上都会产生额外开销,即使没有故障发生也不例外。TorchPass则定位为更轻量的解决方案,更适合运行在数百至数千块GPU规模、故障频率相对较低的训练任务。
独立机构SemiAnalysis对TorchPass进行了基准测试。其技术成员Jordan Nanos表示:"供应商在PPT上声称产品有效是一回事,把它写进合同又是另一回事。在我们的测试中,针对在64块H200集群上运行的GPT-OSS-120B训练任务,与检查点重启方案相比,TorchPass在任务完成时间上表现最快、效率最高。TorchPass在算力利用率和每GPU每秒Token吞吐量上也优于TorchFT,同时恢复时间与TorchFT持平。YOCO保证不过是将我们在测试中观察到的结果以合同形式固定了下来。"
Zheng以谷歌文件系统作类比:"我喜欢回想当年在谷歌的经历,就像谷歌文件系统一样——底层用的是普通机械硬盘,但从开发者的视角来看,你只需要写入一次,确保数据被持久化存储。你不需要关心数据中心里有没有人在换硬盘。"
他进一步表示:"我们同样需要在软件层面建立这样的弹性机制,让开发者或AI研究人员拥有更高的信心,专注于训练本身,而不必为基础设施分心。"
值得一提的是,Clockwork的起点与它如今的方向截然不同:最初,这家公司做的是服务器时钟同步。但正因为这项工作需要极其精确地测量服务器间的延迟,团队发现可以从中获取大量关于集群状态的信息,并由此不断拓展业务边界。可观测性至今仍是Clockwork的核心能力之一。
Zheng表示,TorchPass与Clockwork的监控工具相辅相成:"两者配合得很好——发现问题,就能触发迁移。"目前,公司大量新工作正投入可观测性领域:其集群监控工具现已能将网络互联问题精确定位到具体链路或交换机,相关能力正在与几家大型云服务商开展试点。Zheng说,只要能够足够早地发现GPU性能下滑或链路拥塞问题,TorchPass就能在故障真正发生之前将任务提前迁移。
Q&A
Q1:TorchPass是什么?它是如何解决GPU故障问题的?
A:TorchPass是Clockwork推出的容错产品,已于2025年3月正式上线。当GPU或节点发生故障时,TorchPass能将训练任务的内存状态(包括模型权重、梯度和优化器状态)迁移到健康的备用GPU上,使训练任务继续运行,通常只需几分钟即可恢复,无需回滚检查点或重新计算。
Q2:YOCO保证具体承诺了什么?如果没达标怎么办?
A:YOCO保证(You Only Compute Once)承诺,在受支持的训练任务中,90%的故障将在不丢失进度、不回滚检查点、不重新计算的情况下解决。如果Clockwork在某个合同年内未达到这一标准,客户将获得下次续约或扩容费用25%的抵扣额度,将服务承诺以合同形式落地。
Q3:TorchPass和Meta的TorchFT有什么区别?
A:TorchFT是Meta于2024年底发布的开源框架,应对故障的方式是直接丢弃出问题的副本组,在替换节点就位前以缺失状态继续运行,且每个训练步骤都会产生额外开销。TorchPass则通过实时迁移任务状态来保持训练不中断,定位为更轻量的方案,更适合运行在数百至数千块GPU规模的训练任务。独立测试显示,TorchPass在算力利用率和Token吞吐量上均优于TorchFT。
 0赞
好文章,需要你的鼓励

 推荐文章
英国NHS无人机快递医疗样本服务正式落地伦敦
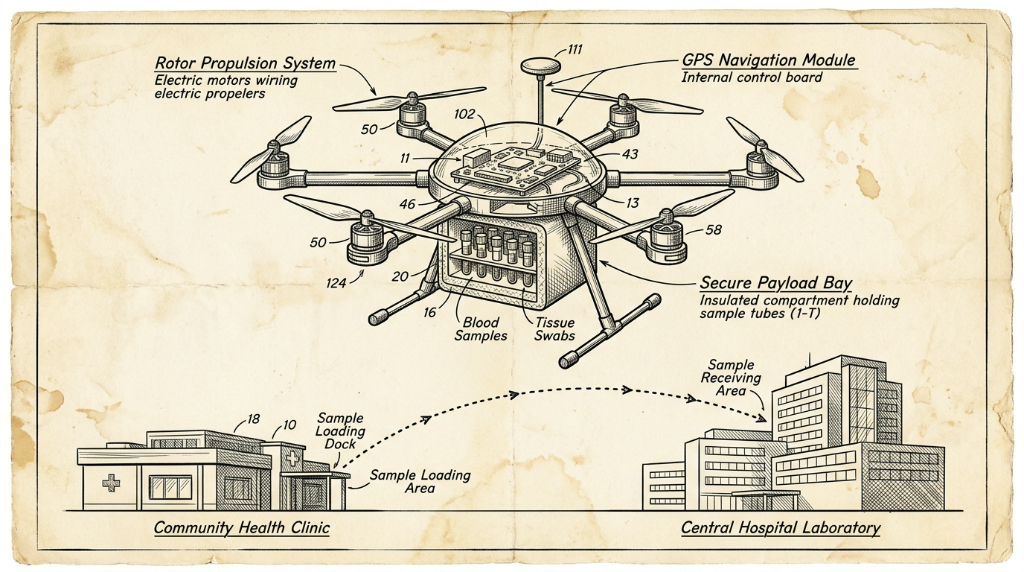
英国国家医疗服务(NHS)正将无人机纳入常规医疗物流体系。自今年2月起,无人机每天在雷恩斯公园和圣乔治医院之间运送血液等诊断样本,飞行仅需3分钟,比公路运输快约85%,且碳排放减少高达98%。目前已有逾2000名患者受益。NHS计划将该服务扩展至圣赫利尔、克罗伊登等多家医院,最终惠及约180万名患者。该网络由英国医疗初创公司Apian与谷歌旗下Wing合作运营。
Explyt团队打造的代码智能体评测新标准:光靠“通过/失败“根本不够用
AgentLens是Explyt公司联合俄罗斯学术机构开发的AI编程助手评测基准,通过分析完整人机交互轨迹而非仅看最终结果,从五个维度评估代码智能体的真实表现。
Aetina宣布支持英伟达Jetson T3000和T2000 AI模块
边缘AI计算厂商Aetina宣布,将在其DeviceEdge AIE-KT风冷系列和新款AIE-PT无风扇平台上支持英伟达全新Jetson T3000和T2000模块。T3000基于Blackwell GPU,最高提供865 FP4 TFLOPS算力,功耗70W;T2000则提供400 FP4 TFLOPS,面向视觉AI代理和自主移动机器人等场景。两款模块预计2027年第一季度上市,支持Nemotron、Cosmos 3等英伟达AI软件生态。
机器人的“触觉觉醒“:韩国梨花女子大学如何让小型AI模型在不忘记视觉的前提下学会“感受“材质
韩国梨花女子大学提出Splash框架,通过识别AI模型中的"休眠参数"并只在其中训练触觉能力,让小型多模态AI在学会感知材质触感的同时,完整保留原有视觉语言推理能力。
2026
07/13
09:08
分享


点赞


中科中成“铁蜻蜓”验证具身智能公卫场景规模化路径
通宇通讯3亿元参股佳贤通信,基站天线厂补上小基站与美国认证
龙头带动、品牌强农——文安县绘就乡村振兴“丰”景图
全新HUAWEI MateBook Fold非凡大师发布 巨幕书写打造折叠电脑巅峰体验
798g 超轻薄,HUAWEI MateBook Pro S 刷新轻薄极限
OpenClaw爆火7个月,一键搭建OpenClaw本地AI环境已不是难题
混合董事会:AI如何重塑董事角色
电力瓶颈推动数据中心向传统枢纽以外扩张
Klaviyo收购Agency,两位科技创始人再度携手
Lightspeed如何通过Instagram私信找到新成员
家得宝重组技术团队,加速创新布局
当AI不再只是“看起来正确”




 京公网安备 11010802021500号 京网文(2025) 0096-033号 京字第20868号